ADBC ➔ PostgreSQL
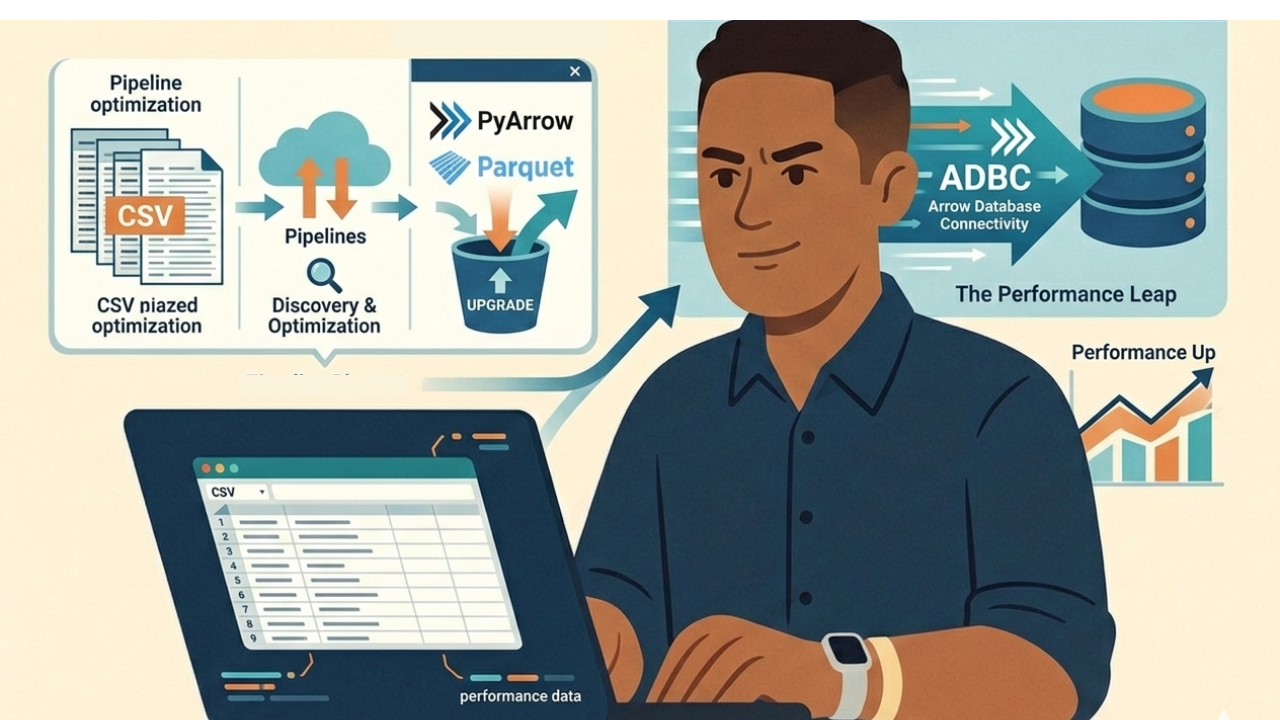
Existem desafios para quem tem como fonte de dados arquivos "csv".
Possibilidade de erros na exportação e importação entre sistemas por
conta da formatação, codificação, delimitadores... além da falta de metadados
e compressão nativa, entre outros.
Em maio de 2024 comecei a procurar por dicas, melhores práticas,
casos de uso... até que encontrei um post de visual simples, em uma
página não tão famosa se comparada a outras.
"How fast can we process a CSV file"
de
Marc Garcia,
desenvolvedor do core do
pandas,
me mostrou que eu achava que sabia trabalhar com "csv"...
e com dados! Ele deixa dois avisos importantes:
"A velocidade de execução nem sempre é o que importa" e "Mais rápido para
um problema pode não ser para outro". Além disso indica o
parquet
como alternativa e apresenta:
PyArrow,
DuckDB,
DataFusion
e
Polars!
Todas essas tecnologias são incríveis, e nesse post mostrou que
Polars
tinha melhor desempenho. Mas, fiquei curioso sobre o
PyArrow...
e mais ainda quando descobri que o
Polars
usa
Arrow
debaixo do capô!
Depois dessas descobertas tinha metade dos problemas resolvidos:
eficiência para leitura, transformação e gravação dos dados.
Mas, precisaria carregar o arquivo
parquet
no
PostgreSQL,
já que onde trabalho queriam os dados no banco.
Então, como carregar os dados com eficiência também?
Encontrei soluções interessantes como
parquet_fdw
e
duckdb_fdw,
extensões de
FDW
(Foreign Data Wrappers) que permite que o
PostgreSQL
acesse e manipule dados de fontes remotas como se fossem tabelas
locais, nesse caso os arquivos
parquet.
Mas não consegui que funcionassem bem.
Então esbarrei em
"Performance Testing Postgres Inserts with Python"
de
Daniel Beach,
um Engenheiro de Dados na Rippleshot que relembra seu início de
carreira carregando dados por meio do
Python
no
PostgreSQL,
visando inserções com melhor desempenho.
Simples, objetivo e usando
psycopg2
!
E o código fica assim:
Como
mogrify
requer uma lista de tuplas, optei por
read_parquet
e
fetchall
para ler e realizar a conversão dos dados, sendo ambos de
DuckDB.
Em seguida uma compreensão de lista passando pelo
mogrify
que fornece uma string em bytes, mas decodificando a saída,
construindo uma string SQL formatada e preparada para ser executada.
Pronto, tudo funcionando bem!
Continuei explorando
PyArrow
e seria inevitável não conhecer
Arrow Database Connectivity!
ADBC
(...para os íntimos!) é um conjunto
de APIs e bibliotecas para acesso nativo do
Arrow
a banco de dados. Como ele tem um
driver para PostgreSQL
e eu estava transformando os dados em uma
pyarrow.Table,
percebi que não era preciso gerar o arquivo
parquet,
diminuindo uma etapa.
O novo código:
O método recebe três argumentos: os dados, o nome da tabela e do
schema
no banco. Agora sim!
Trabalhar com
PyArrow
pode não ser tão amigável como outras tecnologias e a
documentação
vai ser sua maior companheira, mas estou aprendendo muito e me
interessando cada vez mais.
Não fiz "benchmark" com outras tecnologias, mas o ganho de desempenho é notável!
Ahhh... não desisti do
parquet!
Tenho estudado sua utilização em
Object Storage
como
S3,
MinIO...
é uma tecnologia incrível!
E você, o que achou? Como faria?
Obrigado pela leitura.