Convertendo datas com PyArrow
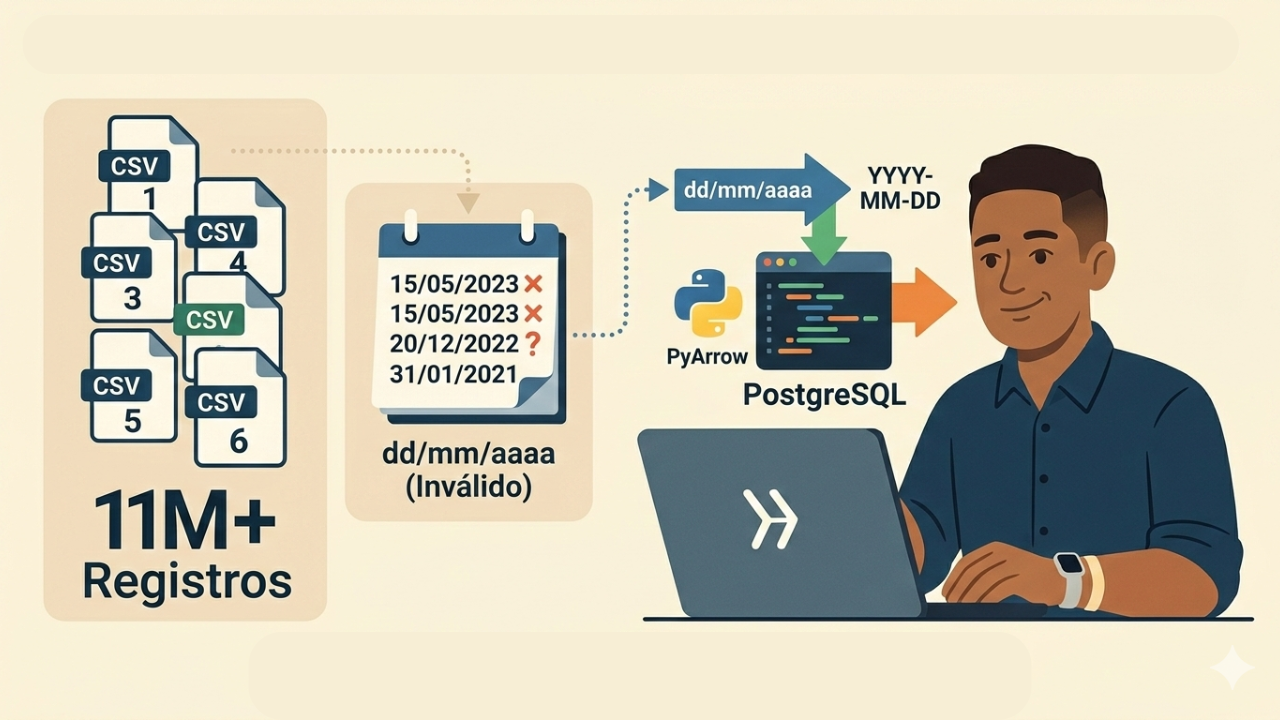
Precisava carregar no
PostgreSQL
seis arquivos "csv", cada um com aproximadamente 11 milhões de registros.
Ao abrir um dos arquivos, me deparei com quatro colunas de data no
formato: "dd/mm/aaaa".
Poderia converter com
PostgreSQL,
Pandas,
DuckDB ...
mas como seria usando o
PyArrow?
Como é uma "string" de data, logo me veio em mente
strptime e
strftime,
ambos da biblioteca
datetime.
Procurei na
documentação
algo com o mesmo nome e encontrei em
pyarrow.compute,
que é um módulo com operações e funções que podem ser
usadas para
agregação,
seleção,
comparação,
conversão,
etc.
Para esse post criei alguns dados...
E o código fica assim:
Começo definindo uma função interna ("setDateFormat") que fará a conversão.
Receberá como argumento um
pyarrow.ChunkedArray
gerado por
pyarrow.Table.itercolumns,
no loop. Faz o parse da "string", a formata e converte o tipo para
pyarrow.date32,
já que não precisava ter nas datas: "horas", "minutos" e "segundos".
Caso fosse necessário, usaria
pyarrow.date64.
Ao ler o arquivo "csv" passo dois argumentos: o nome dos campos presentes no arquivo
(...com possibilidade de já renomear!), e um mapeamento explícito do campo e
seu tipo, que inicialmente é "string" para todos. Obtenho uma
pyarrow.Table,
e dela seleciono as colunas que serão convertidas.
O loop me dá também o nome de cada coluna para utilizar em
pyarrow.Table.drop_columns e
pyarrow.Table.append_column.
Exclui a antiga e adiciona uma com novo formato, respectivamente.
Como alternativa poderia ter usado o
pyarrow.Table.set_column.
Por fim, carrego os dados no banco utilizando o
ADBC.
Sem sobrecarga de memória e o desempenho é notável!
E você, o que achou? Como faria?
Obrigado pela leitura.