Começando uma API para Self-Service BI (Parte 1)
Acesso aos dados por meio do
Excel,
via
R
ou alguma
solução amigável
para analistas com ou sem familiaridade com
linguagens de programação
e
SQL,
erros no driver de conexão do
PowerBI
com nossa fonte de dados principal, enriquecimento de dados durante as transformações
nos pipelines, paixão por
JSON,
minha curiosidade e aprendizado contínuo foram motivos que me fizeram pensar que uma
API (Application Programming Interface)
poderia ser parte da nossa "stack de dados". Entendiamos que a descentralização do acesso aos
dados aumentaria a autonomia de muitos setores em suas análises, além de fomentar a
cultura de ser orientado por dados,
que era o objetivo da minha coordenação, compartilhado em meu post
Como foi ser um Estagiário de Dados?.
Hoje depois de um ano, provavelmente não a escolheria como primeira opção. Mas ter encarado o
desafio,
ver o projeto sendo utilizado e trabalhar nas melhorias, trouxe muitos aprendizados! Não está mais
em
funcionamento, pois optaram por adquirir uma plataforma baseada no
Apache Hadoop.
Recriei a estrutura para continuar
meus testes e descobertas
e validar a abordagem chamada de
Self-Service BI,
que permite que usuários de negócio acessem, explorem e visualizem dados sem
depender de muitos conhecimentos técnicos.
Para começar o desenvolvimento fiz pesquisas sobre a criação de uma
API,
e haviam muitos resultados que recomendavam e relacionavam a
"alto desempenho" e "escalabilidade" o
Node.js...
então, desapeguei-me do
Python.
Não demorou muito tempo para ter vários arquivos e uma dificuldade de manter organizado o projeto,
e por isso comecei a pensar como poderia diminuir as redundâncias e facilitar as inserções de
endpoints
e tecnologias. Analisando o que tinhamos mapeado de dados e regras de negócio durante a criação
dos
pipelines,
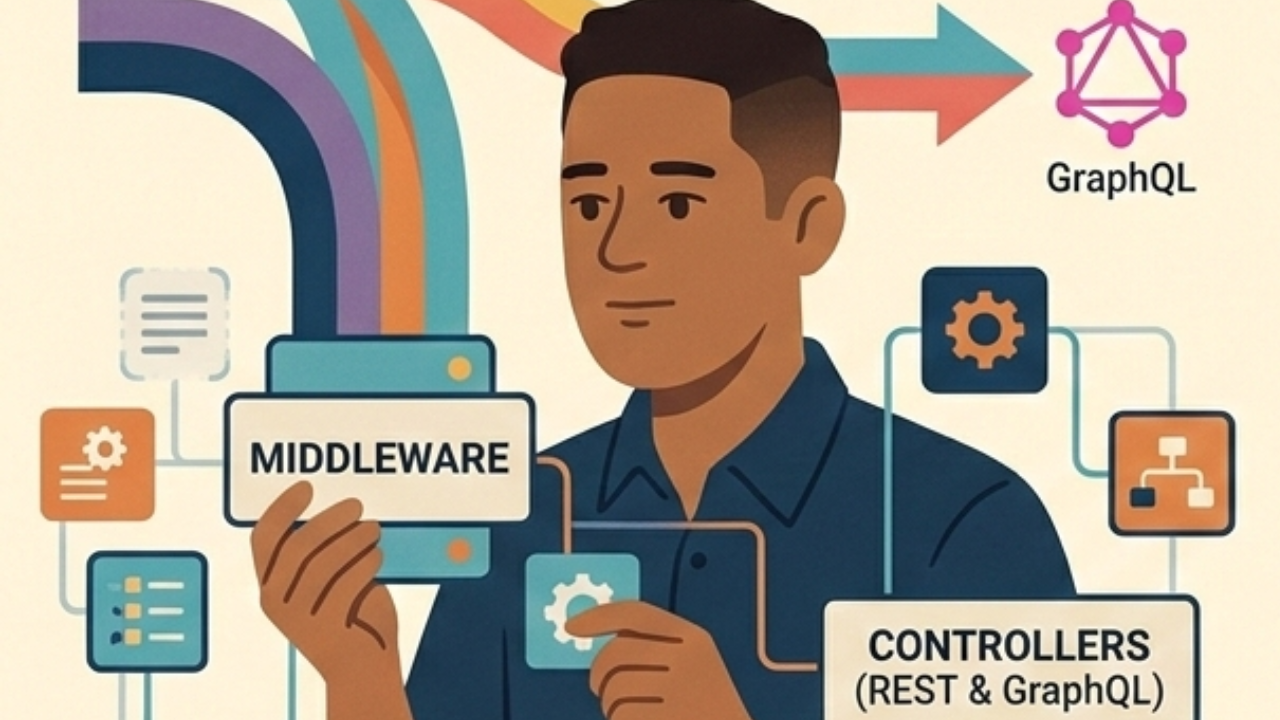
identifiquei três formas prováveis de requisições.
E os
Controllers:
Em
dates
é aceito duas datas no formato
ISO 8601,
como em
BETWEEN.
Já
multi
aceita um ou vários valores, como em
IN.
GetHandler
verifica se foram enviados os parâmetros, se são válidos e então cria um
objeto
com os dados da requisição (...vou falar mais sobre!).
Alguns
pipelines
e
dashboards
precisavam da última data existente nos dados, e por isso também aceitava receber como valor:
max.
Mesmo que seja possível direcionar as requisições para um único
controller,
a validação será específica. Com o tempo, dependendo da quantidade e diversidade de consultas,
fica grande e inviável de manter. Por isso sempre que possível direcionava para
dates,
pois para análise de dados períodos são relevantes. Mas, continuo buscando alternativas.
Por fim:
noparams.
É para requisições sem parâmetros, ideal para baixo/médio volume, pois retorna todos os dados.
Seu foco eram os dados que complementam e enriquecem as tranformações no
ETL.
Em algumas consultas, dependendo do cliente/usuário dos dados, aconteceria
over-fetching
ou
under-fetching.
Pesquisando descobri que
GraphQL
poderia me ajudar e não precisaria me desfazer da estrutura
REST,
pois o
Express.js
conseguiria trabalhar simultaneamente com as duas arquiteturas.
Nesse ponto fiz alguns testes e resolvi armazenar alguns dados no
MongoDB.
Um dos motivos foi o método
populate
da biblioteca
mongoose,
que permite substituir referências em um documento
(...como IDs de outros documentos!) por seus documentos relacionados,
ou seja, ao invés de várias consultas separadas, possibilita buscar
dados em uma única consulta.
Agora tinham requisições com estruturas diferentes sendo direcionadas
para o
Sequelize
e
mongoose
que trabalham de forma distinta.
Então para que fosse independente da "origem" e "destino", a solução foi criar um
objeto
para padronizar a consulta, como abordarei na
Parte 2.
E você, o que achou? Como faria?
Obrigado pela leitura.